Stable Signer: 平衡三方利益的图像溯源协议
目录
一张生成图片经过裁剪、调色和转发之后,我们还能找到它的来源吗?
Stable Signer 通过调整生成模型的部分参数,让输出图像携带可提取的用户标识。不同模型共享提取器,模型提供方则保留对水印嵌入方式的控制。
设计这套协议时,我关心三件事:模型公司是否愿意接入,第三方能否跨模型溯源,以及用户是否会为此承担画质损失、误判或隐私风险。
先看效果:图片相似,携带的消息不同
下面每一行都使用相同的 prompt 和 seed,先生成同一个 latent,再分别用原始和经过调制的 VAE decoder 解码。这样,差异来自解码器的改变,而不是两次随机生成的不同。
| 样例 | 原始解码器 | 水印解码器 | 绝对像素差 ×28 |
|---|---|---|---|
| Observatory | 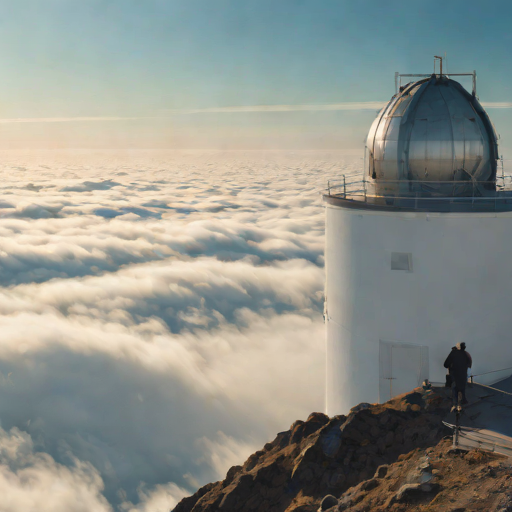 | 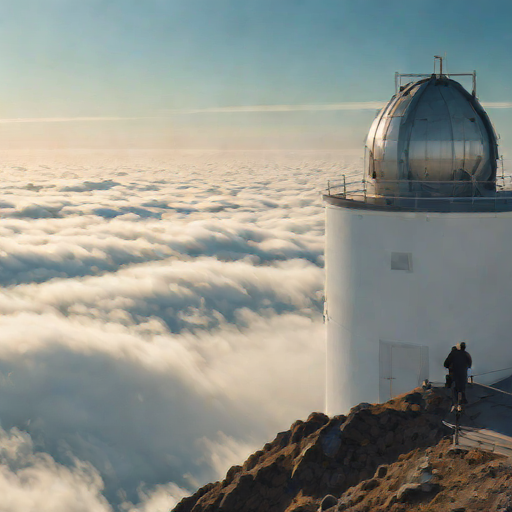 | 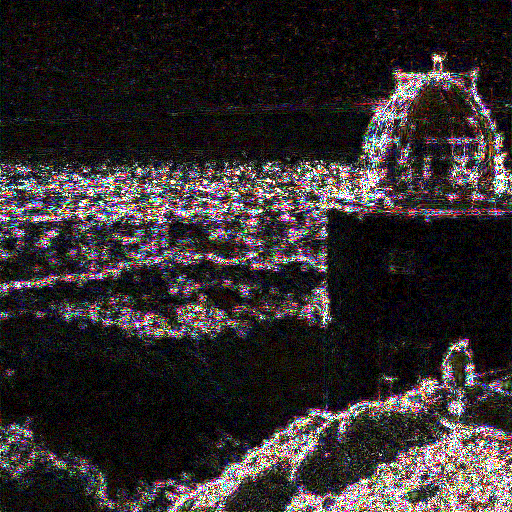 |
| Kingfisher | 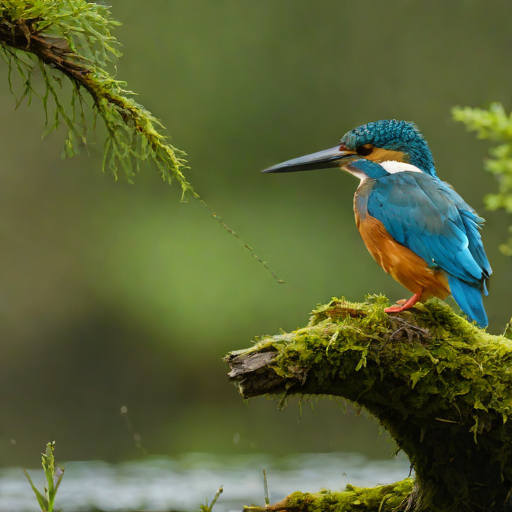 | 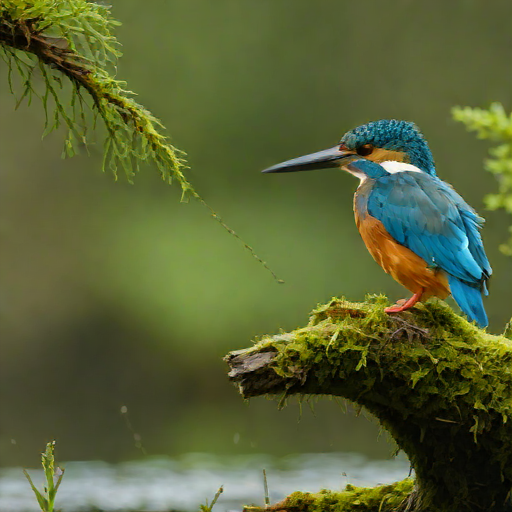 | 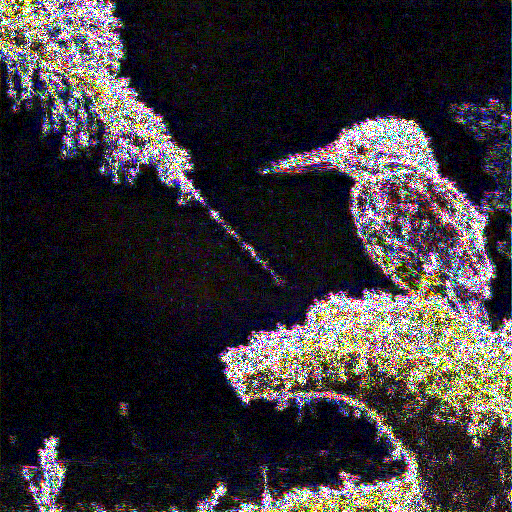 |
| Ceramics | 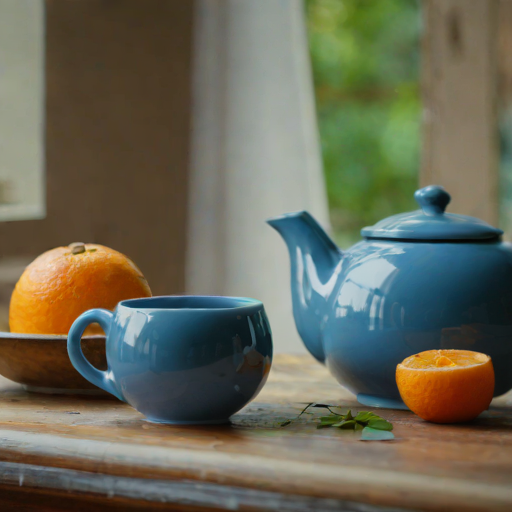 | 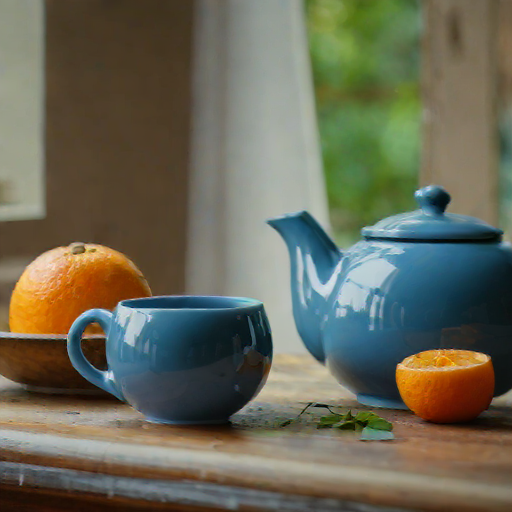 | 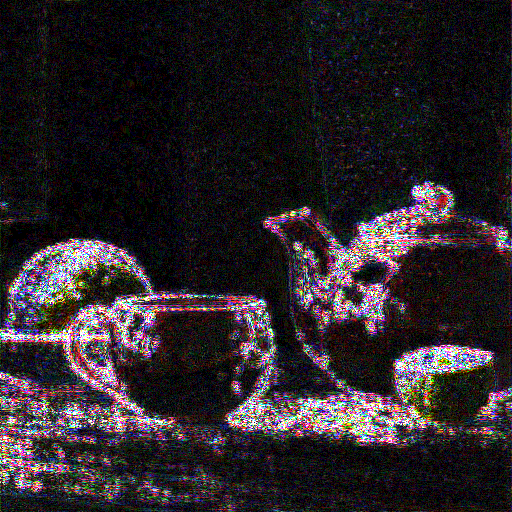 |
每条消息长 48 bits,三组样例分别恢复了 46、48、48 bits。差分图将绝对像素差放大 28 倍,并截断到显示范围,用来观察变化的位置;它不代表实际可见的失真强度。
在 Demo 中选择这三组预计算样例,可以一起查看生成、图像攻击和模型攻击的结果,不需要等待现场推理。也可以自行输入 prompt、seed 和消息,尝试实时生成。
各方为什么愿意接入
水印最直观的做法,是生成图片后再运行一个嵌入器。但如果使用者能够直接运行生成模型,这一步未必会被执行。模型级水印把嵌入机制移进生成过程:使用特定模型参数生成的图片,本身就倾向于携带指定消息。当然,拿到模型权重的人也可以尝试改动这些参数;这只是改变了攻击发生的位置,并没有消灭攻击。
Stable Signature 展示了一条很有启发性的路径:针对固定消息调整 latent diffusion model 的 VAE decoder,让一个预训练提取器从输出图片中读回这条消息。我们的研究沿用其提取器,并进一步关心两个问题:如何更方便地为不同用户赋予不同消息,以及不同模型提供方如何接入同一套第三方溯源机制。
如果只把问题写成“提高 bit accuracy”,很容易遗漏决定方案能否被采用的约束。
| 参与方 | 需要解决的问题 | 对设计的影响 |
|---|---|---|
| 模型提供方(provider) | 不愿交出原始权重和全部架构细节;不能接受明显画质损失;希望新增用户不必重新训练一遍 | 模型专属的参数编码留在 provider 一侧;质量进入训练目标;用消息条件化的 mapper 生成调制 |
| 第三方溯源机构 | 不希望每接入一个模型,就维护一套完全不同的提取流程 | 共享提取器和消息接口,同时允许每个模型有自己的 mapper |
| 正常用户 | 希望图像质量不被破坏,也不希望因一次统计误判被认定为内容的责任人 | 把提取、匹配和身份判断分开;评估误报与错误溯源;为权限、审计和申诉留下明确要求 |
我们将负责溯源的第三方称为 regulator。它可以是一个独立机构,不必特指政府部门。
要让模型公司接入,我认为一个重要前提是:具体怎样修改模型,应当由 provider 自己决定。
例如,选哪些层、怎样分组、使用多大的低秩分解、mapper 需要输出多长的向量,都应与 provider 自己的模型有关。第三方需要知道如何通过这个接口训练和使用 mapper,却不必为了执行这件事直接持有完整模型权重。
这改变了“统一”的含义:统一的是双方如何协作,而不是各家模型的内部实现。
一个接口,两侧各自保留什么
把这套机制串起来:
消息 m → 模型专属 mapper → 紧凑向量 ψ
                                ↓ provider 的参数解码规则
                         带消息的生成模型
                                ↓
                            输出图像 y
                                ↓ 共享 extractor
                           提取消息 m̂
其中,mapper 和参数解码规则合在一起,可以理解为一个 hypernetwork:它根据消息生成另一个网络所需的参数变化,而不是直接把消息叠加到图片上。
| 一侧 | 在研究框架中的职责 |
|---|---|
| Provider | 持有原始生成模型;选择参数编码、层和 rank;执行生成与模型侧反向传播 |
| 第三方 | 持有共享提取器;为每个接入模型训练相应 mapper;执行消息提取与登记消息的匹配 |
| 双方之间 | 约定向量维度与协议;在联合训练中交换 proxy、生成样本和必要梯度 |
注意,共享 extractor 不等于共享同一个 mapper。每个模型仍然需要适配和训练。更换层、rank 或输出维度,也不是在部署时随便改一个数字:对应的 mapper 和参数解码规则必须保持兼容。
模型侧的参数编码依次经过选择参数、空间压缩、低秩分解、展平和置换,得到双方交换的向量。解码则按约定的层和形状,从这个向量构造参数变化。由于前面做了选择和压缩,这不是对任意模型权重的可逆编码。
这是一种 gray-box 协作:第三方没有直接拿到原始权重,但仍能接触向量维度、训练样本和梯度。减少直接披露是有意义的;它却不是“第三方绝不可能推断模型信息”的证明。置换向量也不等于加密。
一串消息,具体怎样改变 decoder
先用一个简化表达描述整体过程。原始生成模型的参数为 θ,消息为 m,mapper 的参数为 φ:
这里 E 输出逐 bit 的分数,最后一行按零阈值转成二进制。Decode 的下标 θ 强调它依赖 provider 持有的原始模型;单独拿到 ψ,并不等于拿到了完整模型。
在当前 SDXL-Turbo 路径中,文本条件和去噪过程先产生 latent,水印调制作用于随后将 latent 解码成 RGB 图像的 VAE decoder。没有为不同消息重新训练文本编码器或去噪网络。
低秩的是调制矩阵,不一定是最终权重差
对一个选中的卷积层,权重 W 的形状为 C_out × C_in × k × k。从 mapper 的输出中取出两组因子:
每一对输入、输出通道共享一个调制系数,这个系数广播到卷积核的空间位置。未选中的层和其他参数保持不变。
它借鉴了 LoRA 的低秩参数化思想,但采用乘性更新 W ⊙ (1 + αAB),不同于通常的加性更新 W + αAB。rank 不超过 r 的是通道调制矩阵 S;实际权重差 ΔW = W ⊙ S 一般不再是 rank-r。
参数量上的直觉很直接。一个 512 × 512 × 3 × 3 卷积有 2,359,296 个权重;rank 为 8 时,两组因子只需要 512×8 + 8×512 = 8,192 个数。代价是表达能力被限制:并不是任意权重变化,都能用这种调制表示。
下面的实验采用 48 位 0/1 输入、没有隐藏层的 mapper,并调制 VAE decoder 中的 15 个卷积层。rank 为 8,α 为 0.01。mapper 的输出为 149,536 维,其中部分分区未使用;具体分区见文末的配置记录。
从“每条消息训练一次”,变成“学习消息到调制的映射”
如果为每个用户的新消息分别优化一份 decoder,新增用户就会带来新的训练任务。这里训练的是函数 M(m):训练时不断采样消息,让它学习怎样为不同消息产生可用的调制。
训练结束后,对一条新的 48-bit 消息,可以通过 mapper 前向计算生成相应参数,不必再为这条消息启动一次优化过程。节省的是逐用户重复训练,不是把用户数量增长带来的所有成本都消掉:参数构造、缓存、模型分发、图像生成、登记和检索仍然需要资源。
怎样训练:画质是一项约束
mapper 需要同时满足两件事:提取器能读回消息,生成图像仍接近原始模型的输出。研究中的目标可以写成:
训练使用 BCE 衡量消息恢复,用 Watson-VGG 感知损失衡量图像变化。对 provider 而言,“最多接受多少画质损失”比两种损失之间的混合权重更容易判断,因此我们把质量预算 ε 直接写进约束。
联合训练分为以下几步:
- 第三方采样消息,运行 mapper,把 ψ 发给 provider。
- Provider 用自己的参数解码规则构造水印模型,对同一输入生成原始图和水印图,并计算感知损失。
- 质量超出预算时,provider 返回对 ψ 的质量梯度,第三方据此更新 mapper;这部分修正有迭代上限。
- Provider 发送水印图,第三方通过保留在自己一侧的 extractor 计算消息损失,再返回对图像的梯度。
- Provider 把梯度反传到 ψ,第三方继续反传到 mapper 参数。
这利用了链式法则划分计算和信息边界:provider 不需要直接持有 extractor 的权重,第三方也不需要直接持有生成模型的权重。它同时引入了样本和梯度传输、双方执行同步,以及训练接口泄露信息的风险。
约束作用于训练采样下的期望损失,质量修正也有迭代上限。因此,它不能保证每个新 prompt、每条新消息都满足同样的质量预算。
当图像和模型被改动后,会发生什么
下面对三组固定 prompt、seed 和消息测试图像变换与模型参数平均。每组取首个生成结果,不按恢复率筛选。
图像级:裁剪、增亮和组合变换
提取是在最终展示的 RGB8 图像上运行,而不是在保存图片之前的浮点张量上运行。输入经过 ImageNet normalization,提取器的输出按零阈值判定 bit。攻击同样作用于这些实际显示的像素。
| 样例 | 水印图,无攻击 | 中心裁剪 | 亮度 ×1.5 | 组合变换 |
|---|---|---|---|---|
| Observatory,seed 23 | 46/48 | 47/48 | 47/48 | 33/48 |
| Kingfisher,seed 41 | 48/48 | 48/48 | 48/48 | 37/48 |
| Ceramics,seed 67 | 48/48 | 48/48 | 48/48 | 36/48 |
表中的中心裁剪保留约 90% 的宽和高,再用 Lanczos 缩放回 512×512;不是只保留 10% 的画面。组合变换则依次保留中央 50% 的宽和高、缩放回原尺寸、亮度乘 1.5,最后以质量参数 80 做 JPEG 压缩。保留一半宽和高,意味着仅保留约四分之一面积。
轻度变换在这三组例子中没有明显破坏恢复,但组合变换使恢复下降到 33–37 bits。天文台样例经过轻度变换后还多恢复了一位,这说明单个样本的阈值结果不必随变换强度严格单调,不能据此说裁剪会普遍改善水印。
样例数只有三组,不能据此估计整体鲁棒性。
模型级:把两个用户的模型平均
如果用户拿到的是带水印的模型权重,而不是只能访问生成 API,那么图像处理并不是唯一的攻击入口。两名用户可以合作,尝试把各自模型的参数平均,稀释各自的标识。
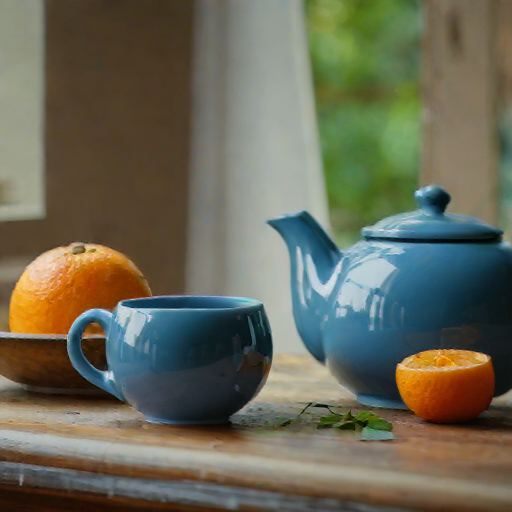
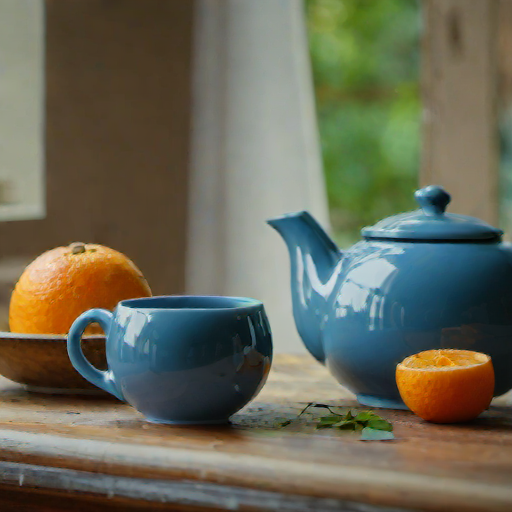
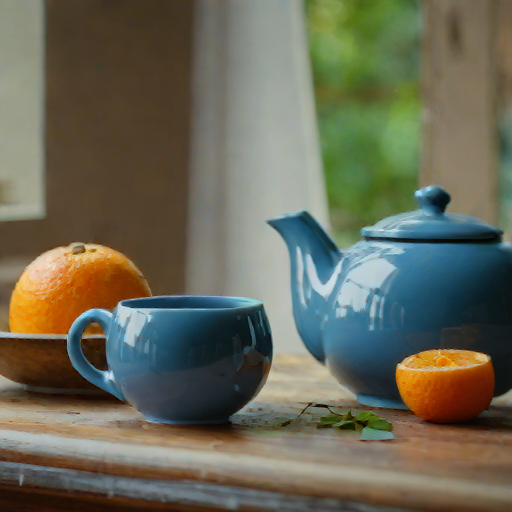
Demo 固定展示一种 50/50 的模型平均。对于共享同一基座 W 的两个 signer:
平均的是完整的参数调制,不是平均 A、B 后再相乘,也不是把两张输出图片混合。合谋模型仍然要对同一 latent 执行一次真正的解码。
| Signer A | Signer B | 平均后的模型 |
|---|---|---|
 |  |  |
| 样例 | 平均模型输出与 A 消息匹配 | 与 B 消息匹配 |
|---|---|---|
| Observatory | 33/48 | 39/48 |
| Kingfisher | 34/48 | 38/48 |
| Ceramics | 20/48 | 28/48 |
Ceramics 中的匹配数降到了 20/48 和 28/48。这组 A、B 消息恰好逐位互补,所以任意提取结果与它们的匹配数之和必然等于 48;20 + 28 = 48 本身不是攻击性能的独立证据。
这些结果说明模型级威胁必须单独评估。它们既不能证明已经可靠识别了合谋者,也不能证明所有水印都被彻底移除——后者还需要明确判定规则和更多测试。
参数到底改了多少
要看参数平均改变了什么,可以把两个消息生成的调制逐层展开。下面两类图使用与图像实验相同的 mapper 和 VAE。
第一类是逐层相对扰动强度:
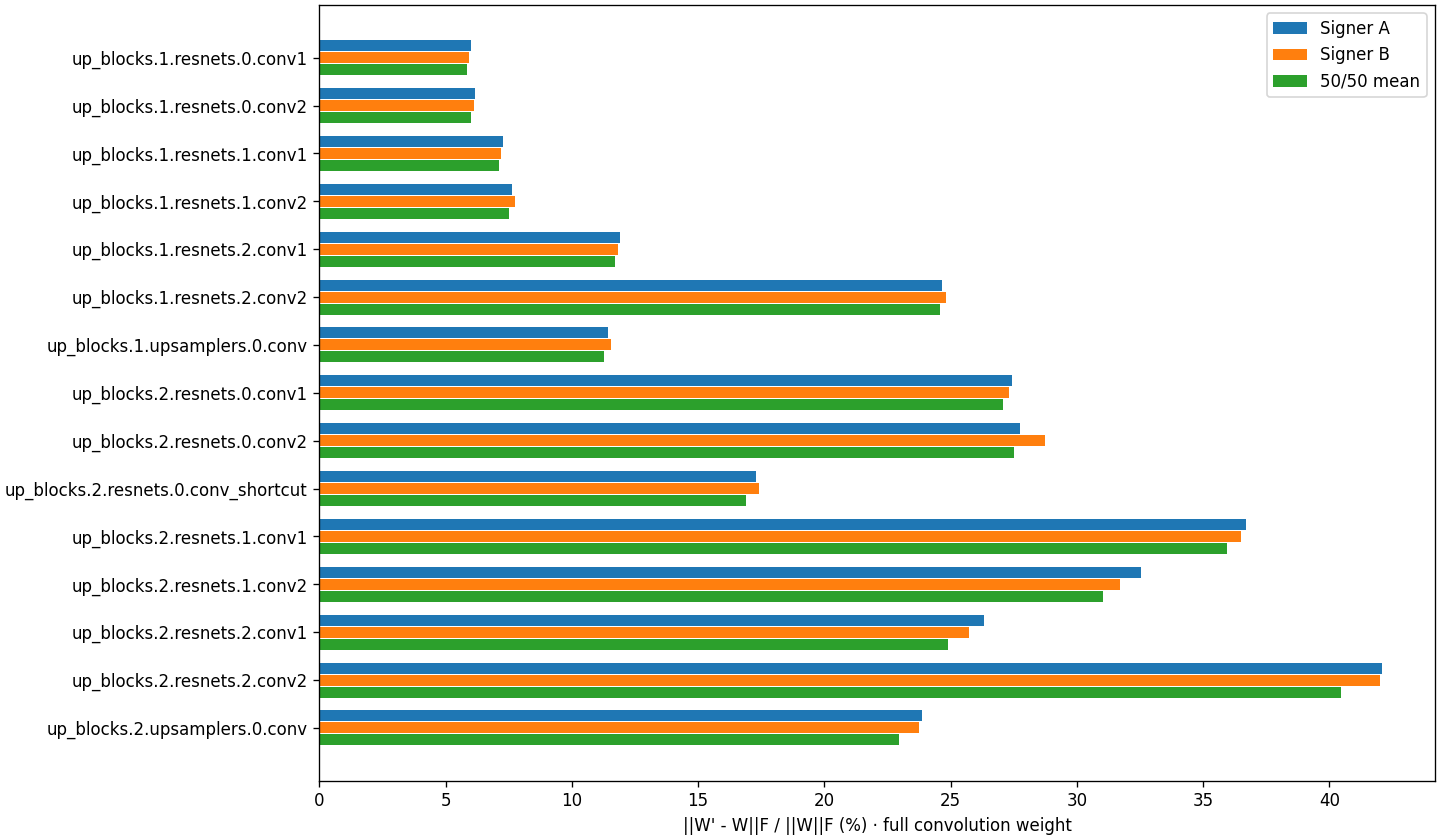
这里用实际执行的 FP32 权重差、以 FP64 累积计算范数,分母是整层卷积权重的范数。天文台样例中,A 的不同层约为 6%–42%。因此,不能因为 α 等于 0.01,就把它描述成“每个参数只改变了 1%”;α 后面还乘着学习到的矩阵乘积。参数变化幅度也不能直接换算成视觉失真。
第二类是通道调制矩阵 S 的热力图。下图对应 up_blocks.1.resnets.0.conv1,依次是 A、B 和二者平均:
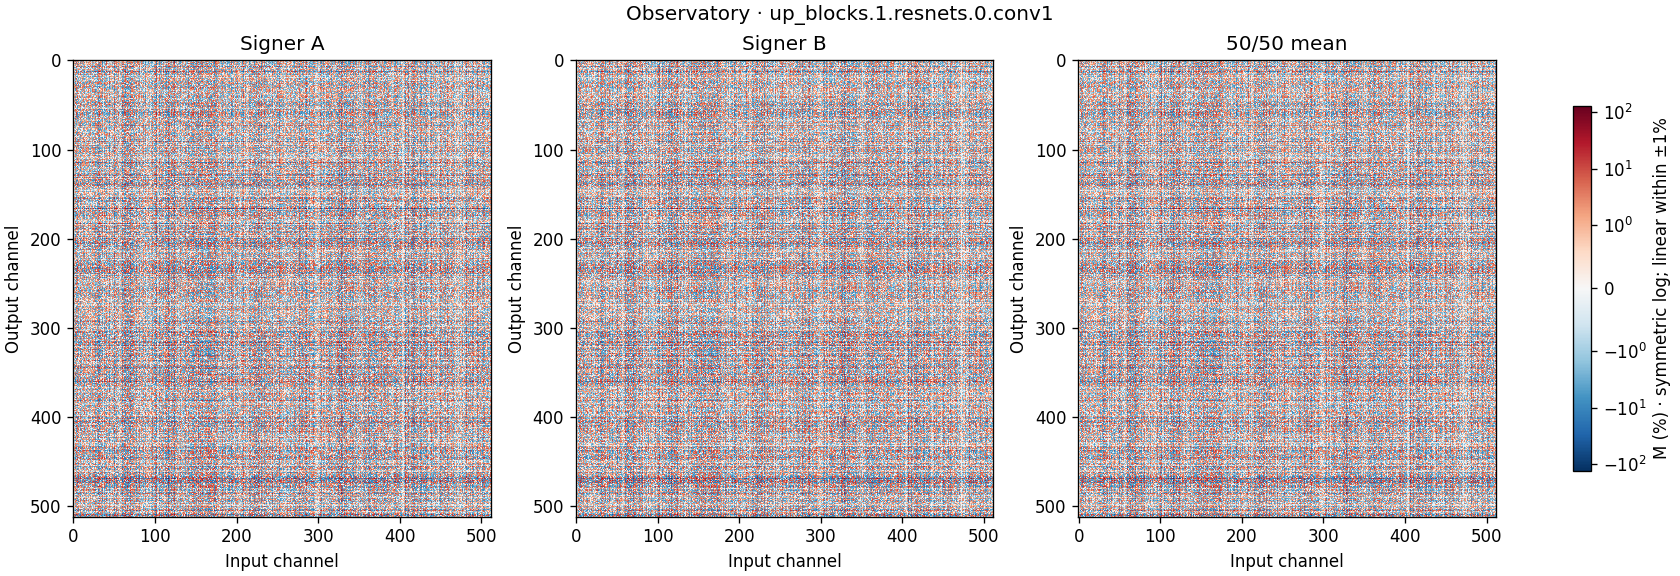
每个格子表示一对输出、输入通道的调制系数,不是图像像素,不是原始权重,也不是绝对权重差 ΔW。三幅图共用以零为中心的对称对数色标,在 ±1% 内线性显示,不对大值截断。色标采用这种形式,是为了同时看清小变化和少数较大的调制。
这些图可以帮助定位“哪些层改变得多”“不同消息的调制哪里相似”,却不是特征语义解释:一个红色格子并不对应图片里的某个物体。要判断某一层对水印恢复是否关键,还需要禁用、替换或扰动该层的受控消融实验。
读出 48 bits,离“找到责任人”还有多远
这里最容易发生的误解,是把 46/48 当作“有 95.8% 的概率来自某个人”。它实际上只表示:提取结果与一条给定消息的 48 个位置中,有 46 个相同。
至少有三个不同的问题:
- 消息恢复:与给定消息匹配了多少位?前面的 bit 匹配率回答的是这个问题。
- 水印检测:匹配是否足够异常,可以拒绝“这是一张没有相应水印的图片”的假设?需要阈值和未标记对照。
- 溯源到用户:在登记的很多条消息里,是否有足够可靠且明确的匹配?还要考虑多重比较、候选冲突和登记系统本身的可信性。
例如,在一个理想化零假设下,如果未标记图像的提取 bits 相互独立,且各自等概率为 0 或 1,那么与固定消息的匹配数 K 服从 Binomial(48, 1/2)。以“至少 t 位相同”为判定规则:
如果同时与 N 条登记消息比较,整体误报概率可用 union bound 上界 N · Pr(K ≥ t | H₀),并且不超过 1。这个上界不要求各次比较相互独立,但单次概率公式依赖前面的 bit 分布假设。实际系统必须用未标记图片、其他模型输出以及实际消息码本校准,不能仅凭三组样例代入公式就宣布达到了某个误报率。Stable Signature 的项目说明也区分了检测、识别以及不同错误类型。
因此,48-bit 的格式不等于已经验证支持 2^48 个可可靠区分的用户;提取出消息也不等于验证了内容的真实性,更不等于证明某个自然人实施了某种行为。“Signer”在这里描述统计水印机制,不是公私钥数字签名。
一个技术方案还缺哪些制度条件
统一提取器减少了技术接入的碎片化,也把能力集中到了第三方。这不是只要提高恢复率就会自动解决的问题。
研究的威胁模型假设 provider 配合接入,并将 extractor 保留在第三方一侧,攻击者不能查询溯源接口。它不解决恶意 provider 主动关闭水印的问题。公开 Demo 为了便于研究和检查,公开了相关实现并暴露提取结果,不能被当作原先“秘密提取器、无查询接口”假设下的安全证明。
对正常用户而言,还必须回答:谁能查询标识,谁能把标识关联到身份,什么情况下允许关联,误判如何复核,登记记录能否被事后改写,以及第三方如何被审计。一个更合理的实际设计可以把随机标识与身份映射分开管理,并为查询设置授权和留痕;这些是进一步的治理要求,不是当前 Demo 已实现的功能。
我最担心的是,统一接口也会集中溯源的权力。第三方如何证明自己始终按约定的规则行事?我们还没有给出密码学或算法层面的保证;把它称为“可信第三方”,并不能解决这个问题。
实验配置与致谢
图像结果使用已训练的 08R checkpoint 在 GPU 上推理;参数图在 CPU 上离线计算。在线演示集中运行推理,不包含双方隔离部署与保密协议。
| 项目 | 本文使用的版本或协议 |
|---|---|
| 基础模型 | SDXL-Turbo,revision 71153311d3dbb46851df1931d3ca6e939de83304 |
| 生成配置 | FP32,512×512,4 steps,guidance scale 0 |
| Mapper | 历史 08R artifact;binary 输入;rank 8;15 个活跃卷积层 |
| 提取协议 | 展示用 RGB8 像素,ImageNet normalization,输出零阈值 |
| 样例选择 | 三组固定 prompt/seed/message,首个结果,无恢复率筛选 |
| 结果索引 | 随文 manifest,含图片哈希、消息、结果及上游记录位置 |
完整记录见 图像结果 manifest、参数诊断 manifest 和 runtime artifact manifest,其中包含各批次生成时的代码版本、配置与文件哈希。
这项研究在浙江大学开展,目前尚未发表。我主要负责框架与算法设计、实现、实验与消融、可视化和论文写作(共同一作)。感谢导师与合作者。
上游工作。 提取器复用 Stable Signature 发布的预训练权重,其 48-bit 架构沿用 HiDDeN 路线。低秩参数化与条件化权重生成分别借鉴 LoRA 和 HyperNetworks。生成基座由 Stability AI 提供,运行依赖 Hugging Face Diffusers。
使用范围。 在线演示仅用于非商业研究。Powered by Stability AI. This Stability AI Model is licensed under the Stability AI Community License, Copyright © Stability AI Ltd. All Rights Reserved. 提取器代码适配与转换权重遵循 CC BY-NC 4.0;相关修改和完整条款见 NOTICE 与 licenses。